

Mi az a Claude Opus 5.5, és mennyivel olcsóbb az Opus 5-nél? A Claude Opus 5.5 az Anthropic 2026. szeptember 22-én kiadott modellje, az új Claude 5.5 család első tagja. Az Anthropic szerint a legtöbb munkán a csúcsmodell Claude Fable 5.1 szintjén teljesít, tipikus munkaterhelésen pedig 40%-kal olcsóbb, mint az Opus 5. Az API-ár 4 dollár / millió input token és 20 dollár / millió output token (−20%), a cache-olvasás 0,20 dollár (−60%). Az Anthropic szerint a kimenetet több mint 30%-kal gyorsabban generálja. A gondolkodás mindig bekapcsolt, az alapértelmezett effort medium. Elérhető a Pro csomagtól felfelé, a Claude API-n és az Amazon Bedrockon EU-s profillal is.
Alig két hónap telt el az Opus 5 július 24-i megjelenése óta, és az Anthropic ezúttal nem a képességekkel nyitott, hanem az árral. Az Opus 5.5 kedden, 2026. szeptember 22-én jelent meg. Nagyjából egy órával később az OpenAI is kiadta két olcsóbb modelljét, a GPT-6 Sol-t és a GPT-6 Lunát. Az árverseny tehát egy napon, egy órán belül indult el mindkét oldalon.
Ebben a cikkben végigvesszük, mit jelentett be pontosan az Anthropic, mit mutatnak a benchmarkok és mit nem. Forintban kiszámoljuk, mennyit spórol egy valós ügynök-munkaterhelésen az Opus 5-höz és a Fable 5.1-hez képest. Megnézzük azt a négy API-változást is, amely a már élesben futó integrációkat megtöri. A végén arról lesz szó, hogyan futtatható az Opus 5.5 úgy, hogy az adat EU-n belül maradjon.
Mit jelentett be az Anthropic 2026. szeptember 22-én?
Az Anthropic hivatalos bejelentése szerint a Claude Opus 5.5 „a legtöbb munkán a Claude Fable 5.1 szintjén teljesít, és 40%-kal kevesebbe kerül a futtatása, mint az Opus 5-é". Ez az első modell a Claude 5.5 családban. A Claude Sonnet 5.5 és a Claude Haiku 5.5 a cég szerint a következő hetekben követi, hasonló teljesítmény-, hatékonyság- és biztonsági javulással.
A modell egyben az Anthropic első kiadása azóta, hogy Dario Amodei vezérigazgató az előző héten a „We Must Pace the Frontier" című írásában a csúcsképességek fejlődésének tudatos ütemezése mellett érvelt. A TechCrunch ezt ki is emeli: az Opus 5.5 a cég szerint több benchmarkon felülmúlja a nagyobb Fable-modellt. Emellett több olyan informális feladatot is megoldott, amelyen a Fable elbukott.
A kiadás előtt két külső szervezet, a Frontier Design és a METR tesztelte a modellt. Ezt a Reuters is megerősíti. A bejelentés öt fő területen ígér javulást: teljesítmény, biztonság, költség és sebesség, valamint kommunikáció. Ez utóbbi az Opus 5 egyik leggyakoribb kritikájára, a nehezen követhető, túl hosszú válaszokra reagál.
Mennyibe kerül az Opus 5.5 az API-n és a Claude-előfizetésekben?
Az árazás a bejelentés legfontosabb része. Az alábbi táblázat a hivatalos Anthropic-árlapról készült 2026. szeptember 23-án. Az OpenAI-sor az OpenAI bejelentéséből származik.
| Modell | Input | Output | Cache-olvasás | Cache-írás (5 perc / 1 óra) |
|---|---|---|---|---|
| Claude Opus 5.5 | 4 $ | 20 $ | 0,20 $ | 5 $ / 8 $ |
| Claude Opus 5 | 5 $ | 25 $ | 0,50 $ | 6,25 $ / 10 $ |
| Claude Fable 5.1 | 10 $ | 50 $ | 0,25 $ | 12,50 $ / 20 $ |
| Claude Sonnet 5 | 2 $ | 10 $ | 0,20 $ | 2,50 $ / 4 $ |
| GPT-6 Sol (OpenAI) | 2 $ | 10 $ | — | — |
A Batch API-n az Opus 5.5 ára a felére esik, 2 / 10 dollárra. A gyors mód (fast mode, research preview) akár 2,5-szeres sebességet ad 8 / 40 dolláros áron. A platform-dokumentáció szerint ez csak a Claude API-n érhető el, a Bedrockon, a Google Cloudon és a Foundryn nem.
Az előfizetőknek is jó hír érkezett. A Notebookcheck szerint az Opus 5.5 a Pro csomagtól felfelé elérhető a claude.ai-on, a Free csomagban nem.
A Mixed News szerint a Claude Code-ban a Pro és a Team Standard csomagon is ez lett az alapértelmezett Opus-modell. Az Anthropic ezzel együtt megemelte az ötórás használati kereteket a Pro, Max, Team és a licencalapú Enterprise csomagokban. Az előfizetők kaptak egy egyszeri limit-visszaállítást is, amelyet elmenthetnek, és akkor használhatnak fel, amikor szükségük van rá. A Claude-árazás korábbi alakulását az Opus 4.7-ről szóló cikkünk Claude árak és elérhetőség fejezete mutatja be.
Opus 5 vs. Opus 5.5: honnan jön a 40%-os megtakarítás?
A 40% két forrásból áll össze: olcsóbb tokenekből és kevesebb tokenből. Az Anthropic szerint az Opus 5.5 ugyanahhoz a feladathoz kevesebb tokent használ, mint az Opus 5, és a kettő együtt adja ki a tipikus terhelésen mért 40%-ot. Ha a saját feladatodon nem csökken a tokenszám, csak az árlistából jövő megtakarítással számolhatsz. Ez a munka jellegétől függően 20% és 60% között mozog.
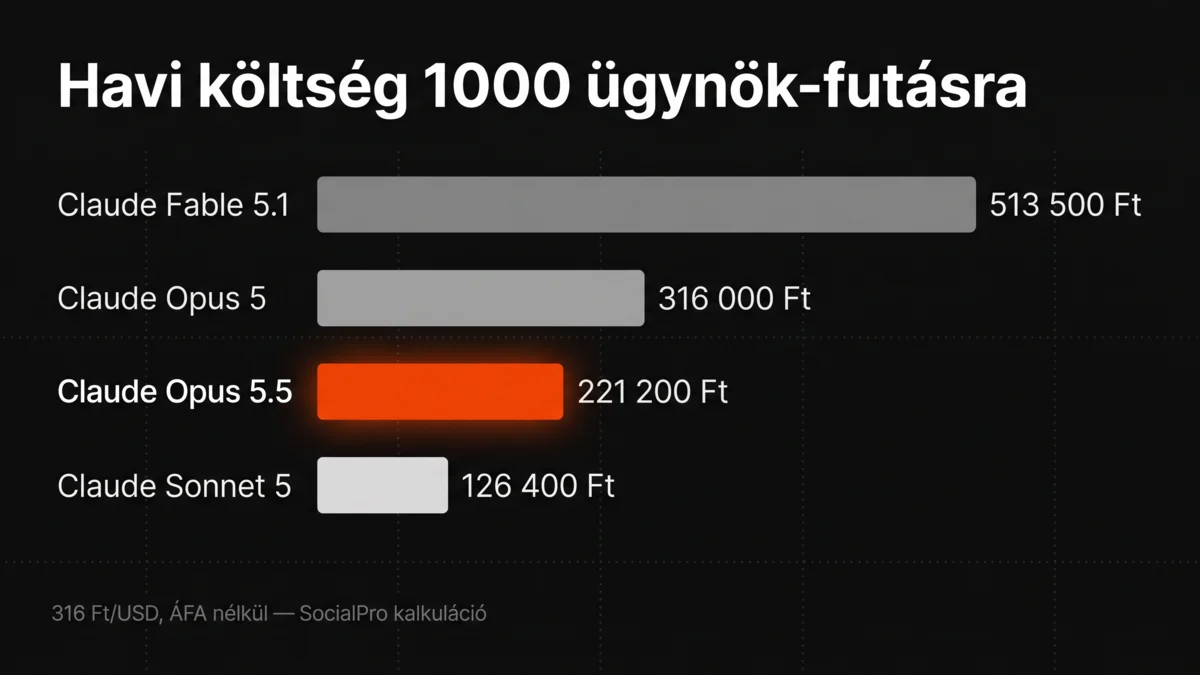
Kiszámoltuk egy tipikus KKV-s ügynök-munkaterhelésre: például egy belső dokumentációból dolgozó ügyfélszolgálati vagy ajánlatíró ügynökre. Egy futás 50 000 új input tokent, 500 000 cache-ből olvasott tokent (a rendszerprompt, a tudásbázis és az előzmények) és 20 000 output tokent használ. Havi 1000 futással és 316 Ft-os dollárárfolyammal számoltunk (MNB-középárfolyam, 2026. szeptember), ÁFA nélkül.
| Modell | Költség / futás | Havi költség (1000 futás) | Eltérés az Opus 5-höz képest |
|---|---|---|---|
| Claude Fable 5.1 | 1,625 $ | 513 500 Ft | +62,5% |
| Claude Opus 5 | 1,00 $ | 316 000 Ft | — |
| Claude Opus 5.5 | 0,70 $ | 221 200 Ft | −30% |
| Claude Sonnet 5 | 0,40 $ | 126 400 Ft | −60% |
Mit jelent ez a gyakorlatban? Ugyanazzal a tokenmennyiséggel az Opus 5.5 havonta kb. 95 000 Ft-tal olcsóbb az Opus 5-nél, és kevesebb mint a felébe kerül a Fable 5.1-nek. Ha a cég által ígért tokencsökkenés nálad is megjelenik, a különbség tovább nő. A cache-olvasás a legnagyobb tétel: ebben a példában az Opus 5-nél a költség negyedét adja, az Opus 5.5-nél már csak hetedét.
Egy rövid, cache nélküli feladatnál más a kép. Egy 10 000 tokenes input és 4000 tokenes output (egy blogvázlat vagy egy e-mail-válasz) az Opus 5-tel 0,15 dollárba, az Opus 5.5-tel 0,12 dollárba kerül. Ez csak 20% megtakarítás. Minél ügynökszerűbb és kontextusnehezebb a munka, annál többet hoz a váltás.
Egy fontos óvatosság: az Opus 5.5 azonos effort-szinten fordulónként többet gondolkodik, mint az Opus 5, főleg xhigh és max beállításnál. A dokumentáció ezért azt kéri, hogy az effort-beállítást ne vedd át automatikusan, hanem mérd újra. A saját 20-30 tipikus feladatodon lefuttatott összehasonlítás többet ér bármilyen gyártói átlagnál.
Mit mutatnak a benchmarkok — és mit nem?
Az Anthropic a bejelentésben öt modellt hasonlít össze: az Opus 5.5-öt, a Fable 5.1-et, az Opus 5-öt, valamint az OpenAI GPT-6 Astra és GPT-5.6 Sol modelljét. Az alábbi számok a cég saját mérései, a Zapier-féle AutomationBench kivételével, amelyet a Zapier futtatott.
| Benchmark (terület) | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 (agentikus kódolás) | 66,4% | 55,8% | 52,3% | 57,9% | 37,3% |
| FrontierCode v1.1 (összevonható kódmódosítás) | 54,4% | 50,3% | 48,0% | 53,3% | 47,5% |
| CursorBench 4.0 (többfájlos kódolás) | 57,8% | 51,8% | 46,6% | — | 41,7% |
| GDPval-AA v2.1 (tudásmunka, Elo) | 1846 | 1735 | 1708 | 1542 | 1588 |
| AutomationBench (üzleti munkafolyamatok) | 40,0% | 31,4% | 26,9% | 41,4% | 28,8% |
| Humanity's Last Exam (eszközökkel) | 67,7% | 65,6% | 63,6% | 57,2% | — |
| Terminal-Bench-Science 0.1 (tudományos kutatás) | 58,7% | 52,6% | 29,0% | 64,6% | 22,4% |
| OSWorld 2.0 (számítógép-használat) | 81,8% | 80,7% | 74,0% | — | — |
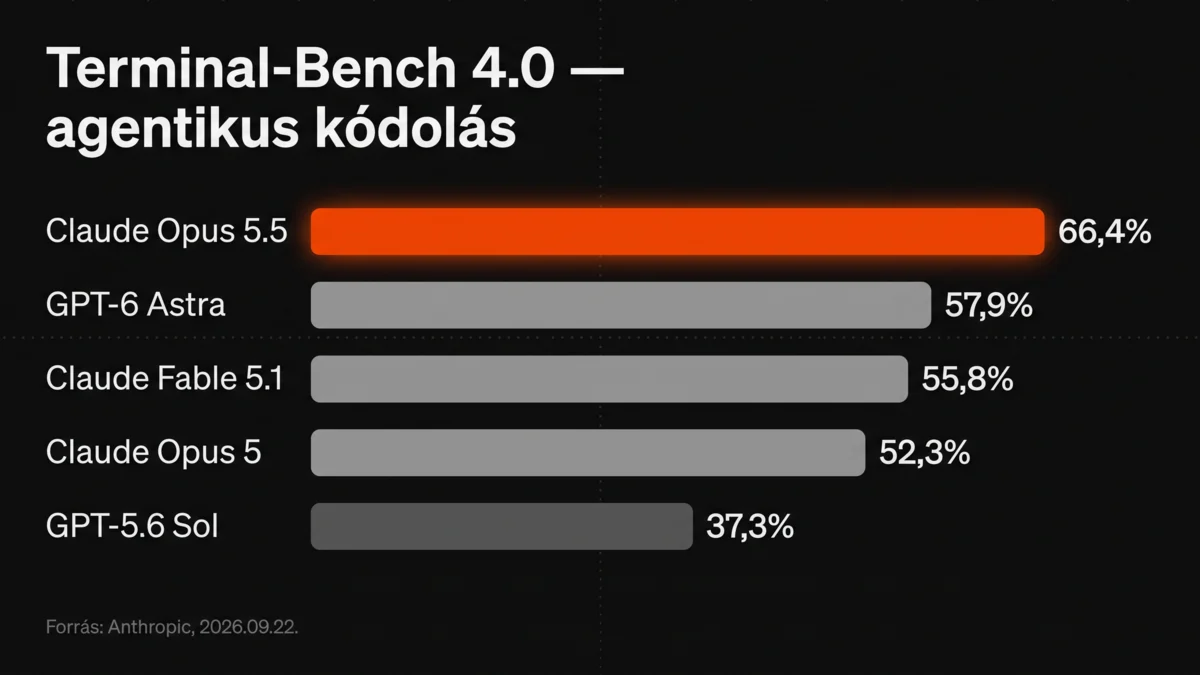
Három dolgot érdemes tudni a táblázatról. Az első: az Anthropic maga is fékezi a lelkesedést. A bejelentés szerint ezen a képességszinten a benchmark-különbségek egyre kevésbé megbízható jelei a valós különbségeknek:
„In our own use, the gap between Opus 5.5 and Claude Fable 5.1 is narrower than these scores suggest."
Magyarul: „A saját használatunkban az Opus 5.5 és a Claude Fable 5.1 közti különbség kisebb, mint amit ezek a pontszámok sugallnak." — Anthropic, Introducing Claude Opus 5.5
A második: az OpenAI ugyanazon a napon kiadott új GPT-6 Sol modellje nem szerepel a táblázatban. A táblázatban az előző, GPT-5.6 Sol szerepel. A VentureBeat szerint a két cég nem közölt azonos környezetben futtatott Opus 5.5–GPT-6 Sol összevetést. Az OpenAI a saját anyagában az Opus 5-höz méri a Sol-t, nem az Opus 5.5-höz.
A harmadik: az Opus 5.5 a méréseken a biztonsági szűrőivel együtt futott. Ahol a szűrő közbelépett, a kiberbiztonsági feladatokat az Opus 4.8, a biológiai feladatokat az Opus 5 végezte el. Ez az Anthropic szerint valószínűleg rontja az Opus 5.5 eredményét ezeken a teszteken.
Mit mondanak a korai tesztelők?
A benchmarkoknál beszédesebbek a céges tesztelők konkrét számai. A GitHub, amely az Opus 5.5-öt már a megjelenés napján elérhetővé tette a Copilotban, a hatékonyságot emelte ki:
„In our testing across GitHub Copilot CLI and VS Code, Claude Opus 5.5 used among the fewest tokens and steps we measured. In VS Code, it solved more terminal tasks than Opus 5 in less than half the steps."
Magyarul: „A GitHub Copilot CLI-ban és a VS Code-ban végzett tesztjeinkben a Claude Opus 5.5 az általunk mért legkevesebb tokent és lépést használók között volt. A VS Code-ban több terminálfeladatot oldott meg, mint az Opus 5, feleannyi lépésnél is kevesebből." — Mario Rodriguez, termékigazgató (Chief Product Officer), GitHub — Anthropic
A Box a válaszok tömörségét mérte, ami közvetlenül a számlán jelenik meg:
„In our evaluations, Claude Opus 5.5 used a third of the tokens Opus 5 did, and its answers were 40% less verbose without losing accuracy."
Magyarul: „A méréseinkben a Claude Opus 5.5 harmadannyi tokent használt, mint az Opus 5, és a válaszai 40%-kal tömörebbek voltak, pontosságvesztés nélkül." — Yashodha Bhavnani, AI-termékekért felelős alelnök, Box — Anthropic
Az Anthropic bejelentésében közölt számok szerint a Deloitte Consulting kódellenőrzésben mért. Carl Bennett informatikai igazgató szerint az Opus 5.5 a legalacsonyabb effort-szinten is az ismert hibák 72%-át találta meg, míg az Opus 5 magas effort mellett 56%-ot. Az Anthropic saját tesztjében egy 200 000 soros kódbázis auditját és javítását az Opus 5.5 három óra alatt végezte el. Az Opus 5-nek ugyanez több mint 20 órába telt, és 2,5-szer annyi tokent használt.
Tudásmunkában is van egy figyelemre méltó eredmény. Az Anthropic belső tesztjében a modellnek egy cég negyedéves teljesítményéről kellett jelentést írnia úgy, hogy a gyorsjelentés nehezen volt megtalálható. Egy automatikus értékelő minden számot és idézetet visszaellenőrzött a forrásokon. Az Opus 5.5 18 jelentéséből 16 ment át a minőségi küszöbön, ahol egyetlen kitalált szám is bukást jelentett. A Fable 5.1 és az Opus 5 egyszer sem érte el ezt a szintet.
Milyen változások törik meg a meglévő API-integrációkat?
Aki az Opus 5-re építve már élesben futtat valamit, annak a „What's new" dokumentáció szerint négy törő változással kell számolnia. Ezek közül az első hármat a Fable 5.1 is hozta, tehát aki arra már átállt, annak ismerős lesz.
- A gondolkodás nem kapcsolható ki. A
thinking: {"type": "disabled"}és a kézibudget_tokens400-as hibát ad. A gondolkodás mélységét azeffortparaméterrel kell szabályozni. Ennek alapértéke ittmedium, az Opus 5-nélhighvolt. - A kényszerített eszközhívás megszűnt. A
tool_choiceanyéstooltípusa 400-as hibát ad. Séma szerinti JSON-hoz azautoés a strict tool use vagy a structured outputs a megoldás. - A gondolkodás-blokkok a modellhez és a beszélgetéshez kötöttek. A 2026. augusztus 31. után létrehozott fiókoknál az API 400-zal elutasítja a kérést, ha egy korábbi gondolkodás-blokk előtti rész (rendszerprompt, eszközök, üzenetek) megváltozott. A beszélgetést csak bővíteni szabad, utólag szerkeszteni nem.
- A régi
computer_20251124számítógép-használati eszköz a Claude API-n és a Google Cloudon már nem működik, helyette acomputer_toolset_20260801kell. A Bedrockon a régi eszköz továbbra is megy.
Van egy csendes változás is, amely nem dob hibát, de a felhasználó észreveszi. Az eszközhívások közötti rövid állapotüzenetek most thinking blokkban érkeznek, alapbeállításban üres szöveggel. Ha az alkalmazásod ezeket élőben mutatja a felhasználónak, az Opus 5.5-re váltás után a felület elnémul az eszközhívások között, amíg be nem állítod a display értéket.
Szigorúbb biztonsági szűrők: kit érint a modellváltás?
Az Opus 5.5 az első Opus-modell, amely a Fable 5.1-hez hasonló szűrőkkel jelent meg a kiberbiztonság, a biológia és a desztilláció területén. Az Anthropic szerint a modell kiberbiztonsági és biológiai képességei a Claude Mythos 5.1-hez mérhetők. A The Verge összefoglalója szerint ezért a kiberbiztonsági kérések egy részét az Opus 5.5 átirányítja a gyengébb Opus 4.8-ra, a szűrő által megjelölt biológiai kéréseket pedig az Opus 5-re.
Egy magyar KKV mindennapi munkáját ez ritkán érinti. A saját kód hibáinak megtalálása és javítása a szokásos fejlesztési folyamat része marad. Egy IT-biztonsági szolgáltatónak viszont számolnia kell vele, hogy a penetrációs teszthez kapcsolódó kérdéseit egy korábbi modell válaszolja meg. Erre az Anthropic egy súgócikket is kiadott. Az ellenőrzött kiberbiztonsági szakemberek számára bővülő Cyber Verification Program a következő hetekben érkezik.
A viselkedési biztonság terén az Anthropic azt írja, hogy az Opus 5.5 az eddigi legjobb eredményt érte el a mintegy 2000 szimulált helyzetet lefedő automatizált viselkedési auditon. Egy új teszten a korlátai kijátszására kb. 85%-kal ritkábban tett kísérletet, mint az Opus 5 vagy a Mythos 5.1. Ez a SiliconANGLE beszámolójában is szerepel. A cég nyíltan leírja a korlátot is: jelek szerint a modell gyakran sejti, hogy éppen tesztelik. Ez megnehezíti annak felmérését, hogyan viselkedik valós környezetben.
Ha felügyelet nélküli ügynököt futtatsz a saját rendszereiden, érdemes elolvasnod a KKV-knak szóló AI-ügynök biztonsági cikkünket. Egy jobban viselkedő modell nem helyettesíti a jogosultságok szűkítését.
Futtatható-e az Opus 5.5 úgy, hogy az adat az EU-ban maradjon?
Magyar cégnél ez gyakran az első kérdés, és a válasz az, hogy igen, de nem az Anthropic saját API-ján. Az Anthropic árlapja szerint a Claude API-n az inference_geo paraméterrel csak USA-n belüli futtatás kérhető, 1,1-szeres szorzóval. Az alapértelmezés a globális útválasztás. EU-s opció az Anthropic saját API-ján nincs.
Az AWS bejelentése szerint viszont az Opus 5.5 az Amazon Bedrockon az első naptól elérhető az EU Geo CRIS (eu.) inferencia-profilon keresztül is, amely az EU-s AWS-régiókon belül irányítja a kéréseket. Ha tehát egy ügyfél szerződése vagy az adatvédelmi hatásvizsgálatod EU-n belüli feldolgozást kér, az Opus 5.5 a Bedrockon keresztül bevezethető. A Bedrock regionális ára eltérhet a Claude API-árától, ezt a Bedrock árlapján érdemes ellenőrizni.
Két további EU-s szempont, mindkettő az Anthropic bejelentésének adatmegőrzési és megfelelőségi részéből. Az Opus 5.5 a Fable 5.1-hez hasonlóan az EU AI Act miatt vízjelet hordoz a szöveges kimeneteiben. A modell nulla adatmegőrzéssel (zero data retention) is elérhető. Hogy ez mit jelent a te kötelezettségeidre nézve, azt az EU AI Act Omnibus KKV-útmutatónkban foglaltuk össze.
Melyik Claude-modellt válaszd most?
A szeptember 22-i állapot szerint az Anthropic modell-áttekintője négy aktuális modellt listáz: Fable 5.1, Opus 5.5, Sonnet 5 és Haiku 4.5. Az Opus 5.5 1 millió tokenes kontextusablakkal, 128 000 tokenes maximális kimenettel és 2026. júniusi tudásdátummal rendelkezik. A saját tapasztalatunk és a fenti számok alapján egy KKV-nak ez a döntési logika működik:
- Opus 5.5 — az új alapértelmezés minden olyan feladatra, amelyre eddig Opus 5-öt használtál: kódolás, hosszú dokumentumok elemzése, ügynök-munkafolyamatok, ajánlatírás. Ugyanazon a feladaton 20–60%-kal olcsóbb, és a mérések szerint jobb is.
- Fable 5.1 — csak ott, ahol a saját méréseden a Fable ténylegesen többet hoz. Az Anthropic szerint a különbség kisebb, mint a benchmarkok sugallják, az input- és outputár viszont 2,5-szeres. A Fable 5.1 részleteit a Fable 5.1 megjelenéséről szóló cikkünk tárgyalja.
- Sonnet 5 — nagy volumenű, rövid és rutin feladatokra marad a legolcsóbb választás, amíg a Sonnet 5.5 meg nem érkezik.
A SocialPro-nál a blogcikkeink kutatási és forrásellenőrzési folyamata a Claude Code-ban fut. Ennek a cikknek a forrásellenőrzése is már Opus 5.5-ön ment. Azt tapasztaltuk, amit a bejelentés a kommunikációról ígér: a lényeg kerül előre, és kevesebb a töltelékszöveg. Egy napos tapasztalatból azonban még korai messzebbre menő következtetést levonni. Az előző generációhoz képest mért különbségekről az Opus 4.8-ról szóló cikkünk ad visszatekintést. Az OpenAI oldalát a GPT-6 Astra cikkünkben néztük meg.
Gyakran ismételt kérdések a Claude Opus 5.5-ről
Mikor jelent meg a Claude Opus 5.5, és melyik Claude-előfizetésben érhető el?
Az Anthropic 2026. szeptember 22-én, kedden adta ki a Claude Opus 5.5-öt, a Claude 5.5 modellcsalád első tagjaként, két hónappal az Opus 5 (2026. július 24.) után. A claude.ai-on a Pro, Max, Team és Enterprise előfizetésekben érhető el, a Free csomagban nem. Fejlesztőknek a Claude API-n (claude-opus-5-5), az Amazon Bedrockon, a Google Cloudon és a Microsoft Foundryn az első naptól elérhető. A Claude Sonnet 5.5 és a Claude Haiku 5.5 az Anthropic szerint a következő hetekben érkezik.
Mennyibe kerül a Claude Opus 5.5 API?
Az Opus 5.5 ára 4 dollár millió input tokenenként és 20 dollár millió output tokenenként, ami 20%-kal kevesebb az Opus 5 5 / 25 dolláros áránál. A cache-olvasás 0,20 dollár (az Opus 5-nél 0,50), a cache-írás 5 dollár (5 perc) vagy 8 dollár (1 óra), a Batch API-n pedig 2 / 10 dollár. Az Anthropic szerint tipikus munkaterhelésen ez összesen 40%-kal alacsonyabb költséget jelent, mint az Opus 5.
Jobb az Opus 5.5, mint a Fable 5.1 vagy a GPT-6 Sol?
Az Anthropic szerint a legtöbb munkán a Fable 5.1 szintjén teljesít, és a cég által közölt mind a nyolc benchmarkon meg is előzi: például a Terminal-Bench 4.0-n 66,4% az 55,8%-kal szemben, a GDPval-AA v2.1 tudásmunka-teszten 1846 az 1735 Elo-ponttal szemben. A cég ugyanakkor maga írja, hogy a saját használatában a két modell közti különbség kisebb, mint amit a pontszámok sugallnak. Az Opus 5.5 ára a Fable 5.1-ének kevesebb mint a fele. Az ugyanazon a napon megjelent GPT-6 Sol-lal nincs közvetlen összevetés: a két cég nem közölt azonos környezetben futtatott mérést. A GPT-6 Sol ára 2 / 10 dollár millió tokenenként, az előd GPT-5.6 Sol-t az Opus 5.5 minden közölt benchmarkon megelőzi.
Mit kell módosítanom, ha Opus 5-ről Opus 5.5-re váltok az API-n?
A model ID-t claude-opus-5-ről claude-opus-5-5-re kell cserélni, és négy törő változást kell kezelni. A gondolkodás nem kapcsolható ki, helyette az effort szintet kell állítani. A kényszerített eszközhívás (tool_choice: any / tool) megszűnt. A gondolkodás-blokkok a beszélgetéshez kötöttek, ezért az előzményeket nem szabad utólag szerkeszteni. A régi computer_20251124 eszköz a Claude API-n és a Google Cloudon nem működik. Érdemes az effort-szintet is újramérni, mert az alapérték medium lett.
Használható az Opus 5.5 EU-n belüli adatfeldolgozással?
Igen, az Amazon Bedrockon keresztül. Az AWS szerint az Opus 5.5 az első naptól elérhető az EU Geo CRIS (eu.) inferencia-profilon, amely az EU-s AWS-régiókon belül irányítja a kéréseket. Az Anthropic saját Claude API-ján az inference_geo paraméter csak USA-n belüli futtatást kínál, 1,1-szeres szorzóval, EU-s opciót nem. A modell nulla adatmegőrzéssel is elérhető.
Megéri-e most átállni a Claude Opus 5.5-re?
A Claude Opus 5.5 az a ritka kiadás, ahol a döntés egyszerű: aki most Opus 5-öt használ, annak szinte minden feladaton érdemes váltania. Ugyanazért a munkáért kevesebbet fizet, és a mérések szerint jobb eredményt kap. Az igazi kérdés inkább az, hogy a Fable 5.1 megéri-e még a 2,5-szeres input- és outputárat. Az Anthropic saját megjegyzése alapján egyre kevesebb feladatnál.
A váltás előtt két dolgot érdemes megcsinálni. Ha API-n dolgozol, nézd át a négy törő változást, mielőtt az éles rendszerben átírod a model ID-t. Mindenkinek érdemes pedig a saját 20-30 tipikus feladatán lefuttatni egy összehasonlítást, mert a 40% átlag, nem garancia. Ha segítség kell ahhoz, hogy kiderüljön, melyik folyamatodban mennyit hoz a váltás, egy 30 perces ingyenes konzultáción közösen végignézzük.
Források: Anthropic — Introducing Claude Opus 5.5 | Claude Platform Docs — What's new in Opus 5.5 | Claude Platform Docs — Pricing | Claude Platform Docs — Models overview | AWS Machine Learning Blog | GitHub Changelog | Reuters | TechCrunch | The Verge | SiliconANGLE | VentureBeat | OpenAI — Introducing GPT-6 Sol and Luna | Dario Amodei — We Must Pace the Frontier | MNB — devizaárfolyamok
A cikk AI-asszisztált kutatással és szerkesztéssel, emberi szakmai ellenőrzés mellett készült. Minden hivatkozott forrást publikálás előtt ellenőrzünk.


